iT邦幫忙

2026 iThome 鐵人賽

DAY 8
0
Build on Google AI

在贏家書寫歷史之前:我所看見的 AI,與一位工程師共舞著系列 第 8

Day 08 | 少年 Token 的奇幻漂流(中):單一 Decoder Block 裡面有什麼?

  • 分享至 

  • xImage
  •  

昨天我們聊到,幾乎所有現代 LLM 都選擇了 Decoder-Only 架構,利用「猜下一個字、再黏回句尾當下一輪的 Input」的自回歸迴圈,逐一把回答輸出。今天我們就來更深入看一下 Decoder 的內部吧。


1. 位置編碼(Position Encoding)

其實這是在前幾天忘記講的內容,文字轉成 Embedding 向量後,在送進模型前還少了一項資訊:「順序」。神經網絡的矩陣運算原本是沒有 Input 前後順序的概念的。如果只看 Embedding,對模型來說 "我 吃 魚""魚 吃 我" 這兩句話查出來的向量集合完全一模一樣。不給順序標記的話,模型根本分不清誰在前誰在後(雖然這句其實兩個都說得通 XDD)。

因此,模型必須引入位置編碼(Position Encoding)

  • 早期做法(絕對位置編碼):把位置向量直接加到 Embedding 上(X = Embedding + PosEmbedding)。這裡的位置向量有多種產生方式,有的是透過特定數學公式算出來(例如正弦餘弦),有的是讓模型自己學習。缺點是一旦文章長度超過訓練時看過的長度上限,模型就不知道那些沒見過的位置該怎麼處理。
  • 現代主流(RoPE 旋轉位置編碼):現代大模型普遍改用 RoPE。做法是在進入 Attention 計算時,依 Token 的位置將向量像指針一樣旋轉特定角度,藉由旋轉後的夾角,跟其他 Token 向量做「內積」,就能計算出彼此的「相對距離」。

有看出跟第一個方法的差異嗎?第一個方法只有「絕對位置」資訊,過程中模型有沒有參考相對位置的資訊其實我們是不得而知的;在第二個方法中,由於作者認為在分析一句話的時候更在乎 Token 之間的「相對距離」,所以將相對位置的資訊在 Attention 階段時被計算出來,因此模型就有了「相對位置」的概念。但我只是打打嘴炮而已,有興趣的人,我把 RoPE論文 放在這裡了 XDD

“Specifically, the proposed RoPE encodes the absolute position with a rotation matrix and meanwhile incorporates the explicit relative position dependency in self-attention formulation.”


2. 走進單一一個 Decoder Block

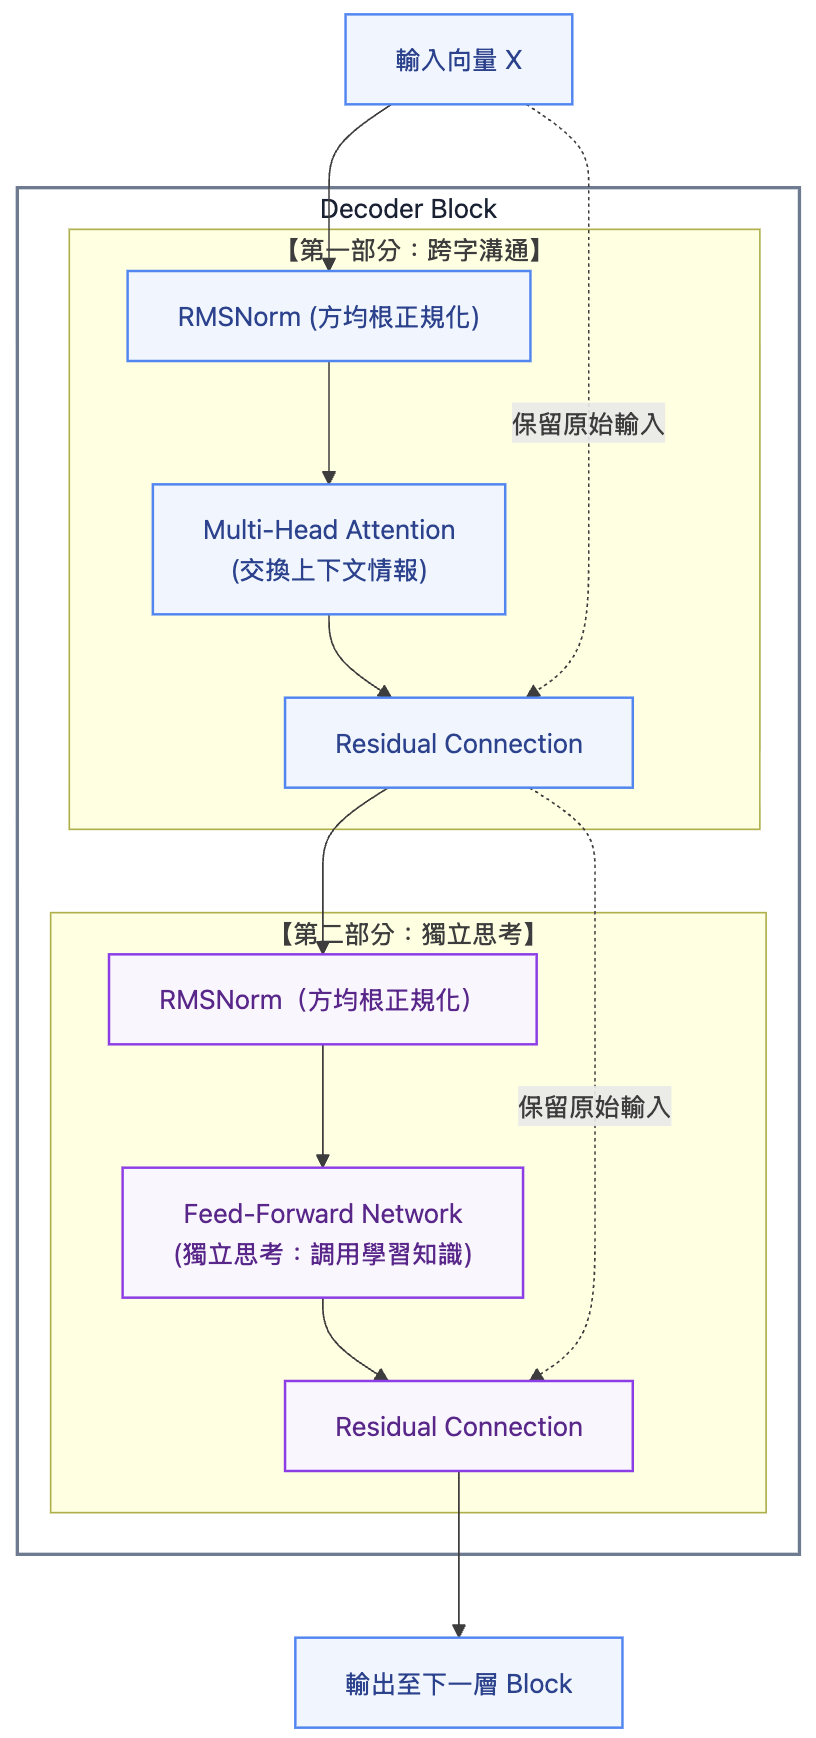
現代大模型的堆疊動輒好幾十、百層 Decoder Block。但無論疊得多深,每一層 Block 的內部結構沒有太大差異,主要由兩大部分串聯而成:
https://ithelp.ithome.com.tw/upload/images/20260921/20183607ed1V6HDOov.png

這兩大部分的目的非常明確:一個負責「橫向溝通」,一個負責「縱向分析」。

  • 第一部分:Multi-Head Attention
    • 目的:讓不同 Token 向量(Hidden State)之間有資訊交流。輸入的單字向量原本彼此是獨立的,這裡要做的是讓 Token 彼此之間交換資訊,達到 「理解上下文」 的目的。
    • 例如:句子出現「蘋果」兩字,單看字面無法判斷是指一種水果還是一間公司(這個例子應該已經被舉到爛掉了 XDD)。Attention 允許當前字回頭看前面的上下文,若看到「新鮮、好吃」,那輸出的向量就會往水果靠攏;若看到「手機、發表會」,那就往科技公司靠攏。
    • 備註:這裡提到「Multi-Head」,可以想成一個 Head 就是一個 Attention 計算,也就是上面說的 Token 向量之間的「資訊交流」的部分,至於怎麼算,我們明天會再詳細說明。每個 Head 輸入並不是原本完整維度,而是把原本的向量維度均分給多個 Head(例如 4096 維切給 32 個 Head,每個 Head 算 128 維):
      • 各自獨立:計算過程中,每個 Head 彼此完全獨立、不互相溝通,各自平行關注不同的特徵(例如語法結構或代名詞等)。
      • 還原維度:每個 Head 計算完後會各自輸出一個 128 維的向量。模型直接將這 32 個 128 維的向量拼接(Concat)在一起,長度就剛好變回原本的 4096 維。
      • 特徵融合:單純拼接只是把各個 Head 的結果排排坐黏在一起,彼此資訊依然沒有交流。因此最後會再乘上一張可學習的權重矩陣(大小為 4096 * 4096,所以輸出還是一個 4096 維的向量),將 32 個 Head 關注到的特徵進行線性組合,然後送往 Residual Connection 與第二部分。

再問:為什麼做特徵融合時,輸出的向量中,每個 Head 的資訊需要有交流過?
因為對照上面的圖,Attention 算完的結果是要做一個 Residual Connection,為什麼這麼做下一節會提到。但簡單來說就是要與原本一開始的 Input 向量做相加,但原本向量資訊都是混在一起的,沒有分什麼 Head,所以在這裡我們也要對齊向量的意義,把每個 Head 的向量結果做資訊上的整合。(其實這個「向量意義」的概念非常重要,很常在做實驗時,把幾個向量做運算,但其實根本不太知道它們各自代表著什麼意思,這時實驗結果就很容易不如預期。)

  • 第二部分:Feed-Forward Network
    • 目的:這裡本質上就是最經典的 Fully Connected Network,也就是最常看到的神經網路,當然訓練時可以採取不同策略參數,但結構大同小異。每個 Token 向量各自獨立通過這組網路,彼此互不干擾。
    • 具體運作:結構非常純粹,就是標準的 「線性轉換 -> 激活函數 -> 線性轉換」
      1. 升維投影(線性轉換):先乘上第一張權重矩陣,將向量維度擴展,放大到原本的 N 倍。
      2. 非線性加工(激活函數):通過激活函數(如現代主流的 SwiGLU 或 GELU),讓模型具備非線性擬合與複雜邏輯判斷的能力。這裡沒有感覺的,可以舉個最簡單的非線性函數例子:f(x) = max(0, x),也就是大名鼎鼎的 ReLU(Rectified Linear Unit)
      3. 降維還原(線性轉換):再乘上第二張權重矩陣,把維度壓回原本的大小。
    • 為什麼需要它?:因為剛剛 Attention 主要是即時的資訊交換與關聯運算,它的權重大多是在學「字跟字之間怎麼找關係」的規則,本身並無法將知識給記憶下來。而海量的百科與世界常識,大部分都存在 FFN 龐大的權重矩陣裡(大模型超過三分之二的參數量都集中於此),這裡才是模型真正調用靜態記憶的地方。

3. RMSNorm 與 Residual Connection

在架構圖中,不論是 Attention 還是 FFN,都搭配了兩個元件:RMSNormResidual Connection。它們是深層網絡能夠穩定運作的關鍵:

  • RMSNorm(均方根正規化)

    • 目的:避免在幾十層的矩陣連續乘法中,向量數值發生失控(數值過大爆炸或過小歸零)。
    • 運作機制:在每一層計算前,將向量數值分佈拉回一個平穩的標準範圍,確保訊息不會崩潰。
  • Residual Connection(殘差連接)

    • 目的
      • 確保訊息保留:保證最初輸入的文字訊號能被保留,不會在深層傳遞中失真或發生梯度消失,簡單來說就是避免走偏。
      • 專注學習增量:每一層神經網路只需要專注學習上一層成果的「增量(Residual 殘差)」,徹底解決深層網絡訊號退化的問題。
    • 運作機制:每一層算完之後,模型不是直接用新結果取代舊資料,而是把原始輸入直接加到這層的計算結果上(這概念在 ResNet 提出後,就有被廣泛使用了)。

根據這幾天的螺旋式學習法,接下來要準備進入到 Multi-Head Attention 元件裡,看一下 Token 跟 Token 之間是用什麼手段計算彼此關係的。

明天高機率會是燒腦的,如果有興趣的話,明天見~


參考資料


上一篇
Day 07 | 少年 Token 的奇幻漂流(上):為什麼現代 LLM 都是 Decoder-Only?
下一篇
Day 09 | 少年 Token 的奇幻漂流(下):深入 Self-Attention
系列文
在贏家書寫歷史之前:我所看見的 AI,與一位工程師共舞著10
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言